Nettoyer le code de son site pour le SEO : méthode et skill Claude
Qu’est-ce qu’il faut nettoyer sur un site pour qu’il performe mieux ? Voici les clés que j’applique sur mes propres sites, dans l’ordre, les chiffres de crawl-ia.com après nettoyage et le skill Claude qui fait ce travail sur le vôtre.
Sommaire 8 parties
- Qu’est-ce qu’un robot lit en premier sur votre page ?
- Comment remonter le texte dans le code ?
- Ce que ce nettoyage a changé sur crawl-ia.com
- Quels footprints IA retirer du code de votre site ?
- Comment ne rien casser en route ?
- Par quoi commencer sur votre site ?
- Le skill Claude pour nettoyer le code de votre site
- Questions fréquentes
En bref
- Google et les robots des IA lisent votre page dans l’ordre du code. Chaque ligne placée avant le H1 repousse le moment où ils saisissent son sujet.
- Faire remonter le texte demande peu de gestes. On déplace le CSS et le JavaScript dans des fichiers, on balise le contenu et on ne garde en tête que l’utile.
- Un site fabriqué avec une IA laisse des traces dans son code (noms de classes, balises, commentaires, métadonnées d’images) qu’on efface en une après-midi.
- Pour le visiteur, rien ne change. Le skill Claude proposé en bas de l’article s’en charge, avec une mesure avant et après.
Ouvrez votre page la plus importante dans Chrome, faites Ctrl+U puis Ctrl+F et tapez <h1.
La barre de défilement a déjà parcouru un bon tiers de la page ? Alors vous tenez la réponse à la question qu’on me pose le plus en ce moment (que faut-il nettoyer sur un site pour qu’il performe mieux). Tout ce qui a défilé sous vos yeux, Googlebot le lit avant votre titre.
C’est ainsi que je nettoie le code de mes sites, fabienraquidel.fr compris. Et crawl-ia.com vient de passer par le même traitement.
Depuis que je procède de cette manière, mes pages se classent le plus souvent mieux et plus vite après leur mise en ligne, avec une exploration un peu meilleure. Je parle en praticien qui constate. Je vous donne ici de quoi le reproduire chez vous.
Mais attention, il y aura toujours des contre-exemples.
Qu’est-ce qu’un robot lit en premier sur votre page ?
Ce que reçoit Googlebot, c’est un fichier HTML qu’il lit de haut en bas. D’abord le <head>, ensuite tout ce que votre thème ou votre générateur a glissé avant le contenu. Votre titre et votre texte n’arrivent qu’après.
Côté IA, la patience est encore plus courte. GPTBot, ClaudeBot ou PerplexityBot n’exécutent pas le JavaScript et s’arrêtent au HTML brut, donc un texte injecté par un script reste invisible à leurs yeux.
Reconnaître un code propre ne demande pas grand-chose. Le premier H1 tombe dans les 3 à 5 premiers Ko du fichier, le CSS et le JavaScript communs sont rangés dans des fichiers séparés et aucune ligne ne laisse deviner l’outil qui a produit la page.
Voyez ce qu’un robot reçoit de votre site. crawl-ia.com interroge votre serveur à la manière d’un robot d’IA et vous affiche ce qu’il récupère, robots.txt compris.
Analyser un siteComment remonter le texte dans le code ?
Sortir le CSS et le JavaScript des pages
Presque personne ne s’en occupe alors que c’est le chantier qui rapporte le plus. Recopiez un bloc <style> de 40 Ko en tête de chaque page et votre H1 recule d’autant, sans compter que le visiteur retélécharge ces 40 Ko à chaque clic.
Le CSS commun a sa place dans un fichier externe dont le nom porte une empreinte (site.3f9a1c.css). Comme la moindre retouche de style modifie ce nom, donc l’adresse du fichier, le navigateur peut le garder en cache pendant un an sans risque de servir une version périmée.
Les gros blocs de JavaScript suivent la même logique. Lors du nettoyage de crawl-ia.com, je suis tombé sur une table de textes d’interface recopiée intégralement dans l’accueil et dans les pages backlinks, en anglais comme en français, alors qu’elle restait identique d’une page à l’autre. Vous ne repérerez jamais ce type de doublon sans ouvrir le code source (Ctrl+U dans Chrome suffit).
En ligne, ne gardez que ce qui change selon la page, par exemple quelques variables de langue ou un jeton de session. Et si ce code appelle des fonctions du fichier externe, respectez l’ordre d’exécution, ce qui exclut defer dans ce cas précis.
Placer le contenu avant le menu ?
Avec un thème WordPress chargé, il arrive que le méga-menu pèse plus que l’article lui-même. Pendant longtemps, la parade a consisté à descendre le bloc <header> en fin de <body> puis à le replacer en haut de l’écran en CSS avec un position:fixed. Je ne la conseille plus pour Google.
Googlebot affiche aujourd’hui la page comme un smartphone avant de l’indexer. Il voit donc le menu en haut de l’écran quel que soit l’endroit où il se trouve dans le code. Un menu fixe mal réglé peut en plus masquer le début du texte ou faire sauter la mise en page sur mobile.
Le déplacement garde un intérêt pour les robots des IA, qui lisent le HTML brut sans l’afficher. Mais le geste utile pour tout le monde reste d’alléger le menu lui-même, avec moins de liens et sans les sous-menus qui recopient la moitié du site.
Avant de toucher à quoi que ce soit, mesurez. Sur crawl-ia.com, une fois CSS et JavaScript sortis, le menu ne représentait plus que 500 octets avant le H1, alors je n’y ai pas touché, parce que remanier la mise en page de toutes les pages pour un gain aussi maigre ne valait pas le risque.
Baliser le contenu
Placez le contenu principal dans une balise <main>, limitez-vous à un seul H1 et laissez le JSON-LD dans le <head>, où il reste léger et utile. En cinq minutes, le robot sait où démarre le sujet de la page.
Ce que ce nettoyage a changé sur crawl-ia.com
J’ai passé crawl-ia.com à la moulinette le 3 novembre 2026, un outil après l’autre. Voici d’abord le poids du HTML qu’un robot reçoit à chaque visite.
| Page | Avant | Après |
|---|---|---|
| Accueil | 220 Ko | 42 Ko |
| Accueil anglais | 145 Ko | 37 Ko |
| Recherche de mots-clés et Tendances | 347 Ko | 12 Ko |
| Trafic des sites | 193 Ko | 37 Ko |
| Backlinks | 170 Ko | 35 Ko |
| Classement | 119 Ko | 44 Ko |
| Check ChatGPT | 52 Ko | 14 Ko |
Ce second tableau indique à quelle distance du début du code le robot croise le premier titre, sans compter le JSON-LD du <head>.
| Page | H1 avant | H1 après |
|---|---|---|
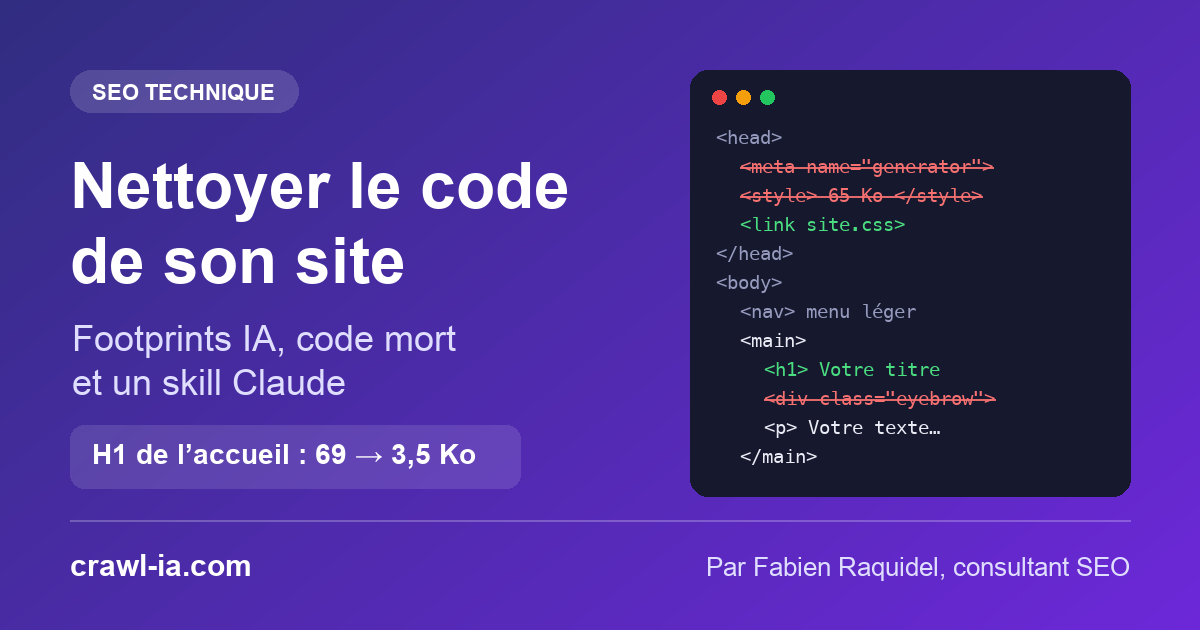
| Accueil | 69 Ko | 3,5 Ko |
| Backlinks | 62 Ko | 4,2 Ko |
| Trafic des sites | 43 Ko | 4 Ko |
| Classement | 30 Ko | 3,9 Ko |
| Recherche de mots-clés | 27 Ko | 4,1 Ko |
| Check ChatGPT | 20 Ko | 4,1 Ko |
À l’écran, le visiteur ne voit aucune différence. Le texte, le tableau du classement et les 100 liens de la page figurent toujours dans le HTML, seul le code dupliqué d’une page à l’autre a disparu.
Quels footprints IA retirer du code de votre site ?
Une précision honnête avant la liste. Google affirme évaluer un contenu sur sa qualité plutôt que sur sa méthode de production. Personne n’a d’ailleurs démontré qu’un nom de classe coûte des positions.
Je nettoie ces traces malgré tout, parce qu’elles arrivent presque toujours accompagnées de code inutile qui alourdit la page. Et un site muet sur sa fabrication ne laisse rien à exploiter, ni pour un concurrent ni pour un client soupçonneux.
Les signatures laissées dans le head
Premier arrêt sur la balise <meta name="generator">, que WordPress, Elementor, Webflow, Wix ou Framer ajoutent par défaut (v0 y inscrit son propre nom de la même manière).
Passez ensuite à la description et à l’auteur. Tant qu’on ne l’a pas terminé, un projet Next.js conserve la description « Generated by create next app », alors que Lovable livre ses projets avec une balise author et une image de partage à son nom. Un titre resté sur « Vite + React » ou la favicon d’origine racontent la même histoire.
L’oubli le plus courant est aussi le plus bête. Servir un site en français avec <html lang="en"> revient à annoncer à Google une page en anglais. C’est pourtant le réglage par défaut de presque tous ces générateurs.
Le vocabulaire des gabarits générés
Les IA de code ont des tics qu’on repère dans les noms de classes. Vous croiserez eyebrow pour le surtitre, lede pour le résumé, deck pour le chapô ou encore kicker, à côté de variables de taille comme --step-1 ou --space-m empruntées à l’échelle typographique Utopia, avec des commentaires en anglais du type <!-- Hero section --> pour séparer les blocs.
Ce lexique anglais trahit la fabrication sur un site francophone. Donnez à ces classes des noms à vous (surtitre, resume, chapo) et retirez les commentaires de section.
Le code mort qu’une IA laisse derrière elle
À force d’itérer, une IA abandonne des pistes sans rien ranger. L’animation supprimée laisse sa classe reveal ou fade-in sur des milliers de balises, la mise en forme retouchée sème des attributs style="…" un peu partout et des blocs <style> traînent au milieu du corps de page.
Dans le JavaScript, traquez les console.log oubliés, les commentaires // TODO et les fonctions que plus personne n’appelle. Vérifiez qu’aucun fichier CSS ni aucun script ne mentionne encore une classe avant de la supprimer, faute de quoi vous casserez un détail que vous découvrirez trois semaines plus tard.
Les images qui disent d’où elles viennent
Téléchargée depuis un générateur, une image conserve souvent son nom d’origine, par exemple « ChatGPT Image » suivi d’une date ou, chez Midjourney, le pseudo et le début du prompt. Donnez à chaque fichier un nom qui décrit ce qu’il montre, ce qui aide au passage votre visibilité dans Google Images.
Le fichier peut aussi embarquer des métadonnées EXIF ou XMP ainsi qu’un manifeste C2PA, cette étiquette qui déclare noir sur blanc une production par IA. Lancer exiftool -all= sur le fichier ou le réencoder en WebP avec cwebp efface l’ensemble, puis un passage d'exiftool confirme qu’il ne reste rien.
Et ce qui se voit à l’écran ?
Une partie des traces se loge dans le texte plutôt que dans le code. Un surtitre à points médians comme « Guide 2026 · Bordeaux · Chartrons », une rafale de tirets cadratins ou un « mis à jour en juillet » jamais actualisé relèvent du contenu. C’est à vous de trancher s’ils restent.
Comment ne rien casser en route ?
Le visiteur ne doit rien remarquer. Sur ordinateur comme sur mobile, il retrouve la même page au pixel près, sinon le nettoyage a raté quelque chose.
Le contrôle le plus fiable consiste à réinjecter le contenu du fichier CSS à la place du lien dans la page nettoyée, puis à la comparer à l’ancienne version. Deux fichiers identiques octet pour octet ne laissent aucune place au doute. Si vous n’y arrivez pas, rabattez-vous sur des captures d’écran prises en largeur ordinateur et en largeur mobile.
C’est cette comparaison qui m’a évité un piège bête en PHP. Le moteur supprime le saut de ligne placé juste après une balise ?>. Résultat, toutes mes pages nettoyées se retrouvaient décalées d’une ligne sans que l’écran en montre la moindre trace.
Gardez aussi une solution de repli. Sur crawl-ia.com, quand un fichier CSS ou JavaScript manque, la page renvoie son code en ligne comme avant (un oubli fait perdre du poids, jamais les styles).
Reste la question de la durée. Un site produit par un générateur, un script ou une IA récupère l’ancien code à la reconstruction suivante, donc écrivez le nettoyage sous forme de script à relancer après chaque mise à jour. Sur WordPress, faites vos modifications dans un thème enfant et laissez le thème parent tranquille.
Par quoi commencer sur votre site ?
Choisissez votre page la plus importante et une page par gabarit, puis attaquez ce qui rapporte le plus avant le cosmétique. On sort d’abord le CSS et le JavaScript communs dans des fichiers mis en cache. On corrige ensuite la langue de la page, la description et les balises laissées par l’outil, avant d’auto-héberger les polices en woff2 plutôt que de les appeler chez Google Fonts.
Viennent après la suppression des styles en ligne, des classes mortes et des commentaires, puis le renommage des classes des gabarits générés et le nettoyage des images. Le menu trop lourd s’allège plutôt qu’il ne se déplace.
Le skill Claude pour nettoyer le code de votre site
Toute cette démarche tient dans un skill, c’est-à-dire un dossier d’instructions que Claude charge quand la tâche s’y prête. Il embarque un petit script Python, mesurer.py, qui relève page par page le poids, la position du H1, la part de texte, les styles et scripts en ligne, les commentaires et les traces d’outils.
Téléchargez le skill nettoyer-code-seo. Un zip avec le fichier SKILL.md et le script de mesure, à installer dans Claude Code ou dans l’application Claude.
Télécharger le zipAvec Claude Code, décompressez le zip dans le dossier ~/.claude/skills/ de votre ordinateur, ouvrez le dossier du site et tapez « nettoie le code de mon site pour le SEO ». Avec l’application Claude, l’import se fait dans les réglages, rubrique des skills.
Le skill démarre par une sauvegarde et une mesure, avance étape par étape et termine sur un tableau avant et après. Il ne touche jamais au texte visible et vérifie le rendu avant de vous rendre la main.
Envie de lire le fichier avant de l’installer ? Le voici en entier.
Voir le fichier SKILL.md
---
name: nettoyer-code-seo
description: Nettoie le code source d'un site pour le SEO sans changer son apparence. Mesure chaque page (poids, position du H1, ratio texte, styles en ligne, scripts, commentaires, traces d'outils et de générateurs), sort le CSS et le JS communs dans des fichiers en cache, allège le menu, retire le code mort et les empreintes laissées par les outils d'IA, puis prouve qu'aucun rendu n'a bougé. À utiliser quand on demande d'alléger, nettoyer, optimiser le code d'un site, de le rendre plus lisible pour Google et les robots d'IA ou de retirer les footprints IA.
---

# Nettoyer le code d'un site pour le SEO

Objectif : un HTML où le texte arrive tôt, sans poids inutile ni trace d'outil, et qui s'affiche exactement comme avant. Le visiteur ne doit voir aucune différence. Le robot, lui, doit en voir une.

## Règles

1. **Rien ne change à l'écran.** Pas de texte modifié, pas de design retouché. Si un changement visible semble utile (titre, surtitre, date), le signaler et ne pas le faire.
2. **Sauvegarde avant tout.** Copier le site (ou faire un commit) avant la première modification. Donner le chemin de la sauvegarde.
3. **Mesurer avant, mesurer après.** Lancer `scripts/mesurer.py` sur un échantillon de pages (accueil, une page de chaque gabarit) avant de toucher au code. Garder la sortie.
4. **Scripts relançables.** Sur un site généré (générateur statique, script, IA), le prochain build remettra l'ancien code. Écrire le nettoyage comme un script idempotent à relancer après chaque build, et le dire.
5. **Un gabarit à la fois.** Sur un CMS (WordPress, Shopify…), travailler dans le thème enfant ou les gabarits, jamais dans le cœur ni dans un plugin qui sera mis à jour.

## Étape 1. Mesurer

```bash
python3 scripts/mesurer.py https://exemple.com/ https://exemple.com/une-page/
# ou des fichiers locaux
python3 scripts/mesurer.py site/index.html site/page/index.html
```

Le script donne pour chaque page : octets, position du premier `<h1>` en octets, ratio texte visible / HTML, nombre de `style="…"`, de blocs `<style>` et `<script>` en ligne (avec leur poids), commentaires HTML, `meta generator`, noms d'outils trouvés dans le code, classes typiques des gabarits générés.

Lire le résultat dans cet ordre :
- **H1 au-delà de ~5 Ko** : le menu, le CSS ou le JS passent avant le contenu.
- **Scripts ou styles en ligne de plus de 10 Ko** : ils sont retéléchargés à chaque page vue et repoussent le texte.
- **Ratio texte sous 25 %** : le code écrase le contenu.
- **Traces d'outils** : à retirer quoi qu'il arrive.

## Étape 2. Sortir le CSS et le JS communs

- Le CSS répété sur toutes les pages va dans un fichier unique, minifié, appelé avec une empreinte dans l'adresse (`/assets/site.css?v=<hash du contenu>`) pour un cache long sans risque de version périmée.
- Même chose pour les gros blocs de JavaScript en ligne. Garder l'ordre d'exécution : si du code de la page appelle des fonctions du bloc, pas de `defer` ni d'`async` sur ce fichier.
- Ne garder en ligne que ce qui change d'une page à l'autre (quelques variables) et, si besoin, le CSS critique du haut de page.

## Étape 3. Mettre le contenu en tête

- Mesurer d'abord ce qui sépare `<body>` du H1.
- Si le menu est lourd (méga-menu, sous-menus qui recopient la moitié du site), l'**alléger** : moins de liens, pas de sous-menus en double. C'est le geste utile pour tous les robots.
- Ne pas déplacer le menu en fin de `<body>` par défaut. Googlebot affiche la page comme un smartphone avant de l'indexer et voit le menu en haut quel que soit son rang dans le code, alors qu'un menu repositionné en CSS (`position:fixed`) peut masquer le haut du texte ou faire sauter la mise en page sur mobile. Le déplacement ne sert qu'aux robots qui lisent le HTML brut sans l'afficher (robots des IA) ; ne le faire que si le propriétaire le demande, et contrôler alors l'affichage mobile (390 px) et les ancres (`scroll-margin-top`).
- Entourer le contenu principal d'un `<main>`.
- Viser un premier `<h1>` dans les 3 à 5 premiers Ko du HTML.
- Les blocs JSON-LD peuvent rester dans le `<head>` : ils sont utiles et légers.

## Étape 4. Retirer le code mort et le bruit

- Commentaires HTML, CSS et JS (sauf licences obligatoires).
- `style="…"` répétés : les remplacer par des classes nommées, règles ajoutées au fichier CSS.
- Blocs `<style>` égarés dans le `<body>` : leurs règles partent dans le fichier CSS, limitées par un sélecteur de page si elles ne valent que pour une page.
- Classes que plus aucune règle CSS ni aucun script n'utilise (animations abandonnées du type `reveal`, `fade-in`, `aos`…). Vérifier par une recherche dans tout le CSS et le JS avant de supprimer.
- Ancres vides, `div` sans rôle, attributs `data-*` d'un constructeur de pages qui n'a plus de script.

## Étape 5. Effacer les empreintes d'outils

Chercher et retirer :
- `<meta name="generator">` (WordPress, Elementor, Framer, Webflow, Wix, Hugo, Astro, v0…).
- Réglages par défaut des générateurs : `<html lang="en">` sur un site qui n'est pas en anglais (le plus fréquent), description « Generated by create next app » (Next.js), titre « Vite + React », balise `author` et image de partage au nom de l'outil (Lovable), favicon par défaut.
- Commentaires ou attributs qui nomment un outil : « Generated by », « Built with », `data-framer-*`, `data-wf-*`, noms de modèles ou d'éditeurs d'IA (Claude, ChatGPT, OpenAI, Anthropic, Gemini, Midjourney, v0, Lovable, Bolt, Cursor…).
- Vocabulaire typique des gabarits générés par IA, à renommer en mots propres au site (en français si le site est français) : `eyebrow`, `lede`, `deck`, `kicker`, `hero-*` en série, variables d'échelle `--step-*` / `--space-*` façon Utopia, commentaires de section en anglais (`<!-- Hero section -->`).
- Restes de développement dans le JavaScript : `console.log`, commentaires `// TODO`, fonctions que plus rien n'appelle.
- Noms de fichiers d'images sortis d'un générateur (« ChatGPT Image … », pseudo et prompt chez Midjourney, « DALL·E … ») : renommer avec des mots qui décrivent l'image, et mettre à jour les `src`.
- Métadonnées des images (EXIF, XMP, manifeste C2PA qui peut signaler une image générée) : réencoder ou nettoyer avec `exiftool -all= image.jpg` (ou `cwebp`, qui n'en recopie pas par défaut). Contrôler avec `exiftool image.jpg`.
- Polices appelées sur un serveur tiers : les auto-héberger en `woff2`, avec `preload` des deux plus utilisées.

Signaler sans corriger les traces qui sont dans le **contenu visible** (surtitres à points médians « Guide 2026 · Ville », tirets cadratins en série, « mis à jour en… » figé) : c'est au propriétaire du site de décider.

## Étape 6. Prouver que rien n'a bougé

- Comparer les styles calculés avant / après avec Playwright sur un échantillon de pages, en largeur ordinateur (1300 px) et mobile (390 px) : pour chaque élément visible, `getComputedStyle` sur les propriétés de mise en page, couleur et police. Objectif : 0 écart. Corriger les écarts de spécificité (une classe qui perd contre un ancien sélecteur) en renforçant le sélecteur.
- À défaut, captures d'écran avant / après et comparaison pixel.
- Valider qu'aucun lien interne, aucun JSON-LD ni aucune balise du `<head>` n'a disparu.

## Étape 7. Rendre compte

Relancer `scripts/mesurer.py` sur les mêmes pages et livrer un tableau avant / après (octets, position du H1, ratio texte, styles en ligne, scripts en ligne, traces trouvées), la liste des fichiers modifiés, le chemin de la sauvegarde et le script à relancer après chaque build. Dire clairement ce qui a été mesuré et ce qui reste une hypothèse : un code plus léger se mesure, son effet sur le classement se constate ensuite dans la Search Console (Statistiques d'exploration, positions).
Le script tourne aussi sans Claude avec python3 mesurer.py https://votre-site.fr/ et ne réclame que Python 3.8 ou une version plus récente. Lancez-le avant la moindre modification, conservez la sortie et relancez-le une fois le travail fini.
Questions fréquentes
Un code source propre améliore-t-il le référencement ?
Le gain se mesure tout de suite (moins d’octets, un H1 placé plus haut, davantage de texte dans ce que reçoit le robot). L’effet sur le classement se lit ensuite dans la Search Console. Sur mes sites, je constate des pages mieux classées et plus vite, le plus souvent.
Quels sont les footprints IA les plus courants dans le code d’un site ?
On retrouve la balise generator, une langue de page restée en anglais, la description par défaut du générateur et des noms de classes comme eyebrow, lede ou deck. S’y ajoutent les commentaires de section rédigés en anglais, les classes d’animation abandonnées en cours de route et des bouts de code qui ne servent à rien, comme un console.log oublié ou une fonction que plus rien n’appelle. Et regardez vos images, qui gardent souvent leur nom de fichier d’origine ou leur manifeste C2PA.
Google pénalise-t-il un site dont le code a été généré par une IA ?
Aucune pénalité de ce genre n’est documentée, Google disant juger le contenu sur sa qualité et non sur son mode de production. Effacer les traces d’outils relève de la prudence et de la propreté du code. Et un code propre, Google le lit plus facilement, ce qui compte aussi.
Faut-il déplacer le menu en bas du code ?
Pour Google, cela ne change presque plus rien puisqu’il affiche la page comme un smartphone avant de l’indexer. Le déplacement sert surtout aux robots des IA qui lisent le HTML brut. Le plus utile reste d’alléger le menu, puis de mesurer ce qui sépare la balise body du H1.
Comment savoir si le code de mon site est trop lourd ?
Ouvrez le code source de la page (Ctrl+U dans Chrome) et repérez le premier H1. S’il apparaît après 5 Ko, le menu, les styles ou les scripts passent avant le texte. Le script mesurer.py du skill sort ce chiffre et tous les autres en une seule commande.
Le skill fonctionne-t-il sur un site WordPress ?
Oui pour la mesure et pour une bonne partie du nettoyage, si vous travaillez dans un thème enfant. Avec un constructeur de pages comme Elementor ou Divi, une partie du code imbriqué reste impossible à retirer sans changer d’outil.